电商数据不出端:英特尔 Agentic PC ×TRAE 本地电商运营智能体实战
 小o
更新于 9小时前
如果订单、客户评价、商品资料甚至客服对话都能在 Agentic PC上完成分析,电商运营会发生什么变化?
本项目给出了一个可以实际运行和验证的答案:
让敏感数据优先留在本机,让 GPU / NPU / CPU 各司其职,让 TRAE 智能体把零散的运营工具串成一条自动化工作流。
在一台英特尔 Agentic PC上,我们搭建了一套 LOCAL-FIRST 电商运营智能体:
订单解析、评价分析、OCR、商品资料处理、客服建议等高频任务优先在本地完成;只有确实需要外部信息时,才连接云端。
整个项目从架构设计、代码实现到测试验证,均由 TRAE 智能体通过自然语言提示词生成,最终完成 27 个测试用例,并验证 GPU / NPU / CPU 三类异构算力的实际运行效果。
一、为什么电商运营需要“本地优先”的智能体?
电商运营每天处理的,并不只是商品名称和价格。
订单里有姓名、手机号、地址和支付信息;
客户评价里有真实的使用反馈和情绪;
商品资料、直播回放、客服对话中,又沉淀着大量可以复用的内容。
这些数据有两个共同特点:
一是量大,二是敏感。
传统的 AI 工作流往往是:把数据发送到云端 → 调用模型 → 获得结果。
对于低敏感度的信息,这种方式没有问题。
但如果处理的是订单、客户信息、售后记录等数据,就会遇到几个现实问题:
- 隐私问题: 手机号、地址、支付信息等数据并不适合无差别上传云端;
- 效率问题: 差评分析、OCR、语音转写等高频任务需要反复调用工具;
- 成本问题: 大量重复任务持续消耗云端 token;
- 流程问题: OCR、ASR、文档解析、文本生成等工具彼此割裂,运营人员需要不断切换。
所以问题并不是“云端 AI 不够强”,而是:
哪些任务应该交给云端,哪些任务其实可以直接在本机完成?
这正是 LOCAL-FIRST 设计要解决的问题。
二、把电商运营搬进一台 AI PC
本项目的核心思路很简单:
TRAE 负责“理解和编排”,英特尔 Agentic PC 负责“本地执行”,OpenVINO™ 负责“让模型跑得更高效”。
具体来说:
- TRAE:理解自然语言需求,拆解任务并编排工作流;
- CPU:处理规则引擎、数据解析、模板生成等轻量任务;
- GPU:承载 BERT 等模型的高频推理;
- NPU:承载 OCR 等适合专用 AI 加速的任务;
- OpenVINO™:负责模型优化、推理以及 CPU / GPU / NPU 设备调用;
- PrivacyGuard + SkillRouter:判断数据敏感程度,并决定任务应该在哪里执行。
最终形成一条本地优先的智能工作流:
用户意图 → 数据分级 → Skill / Engine 路由 → GPU / NPU / CPU 执行 → 结果返回
只有在确实需要外部信息时,才进入云端。
三、先看 Demo:一套“看得见本地 AI”的电商工作台
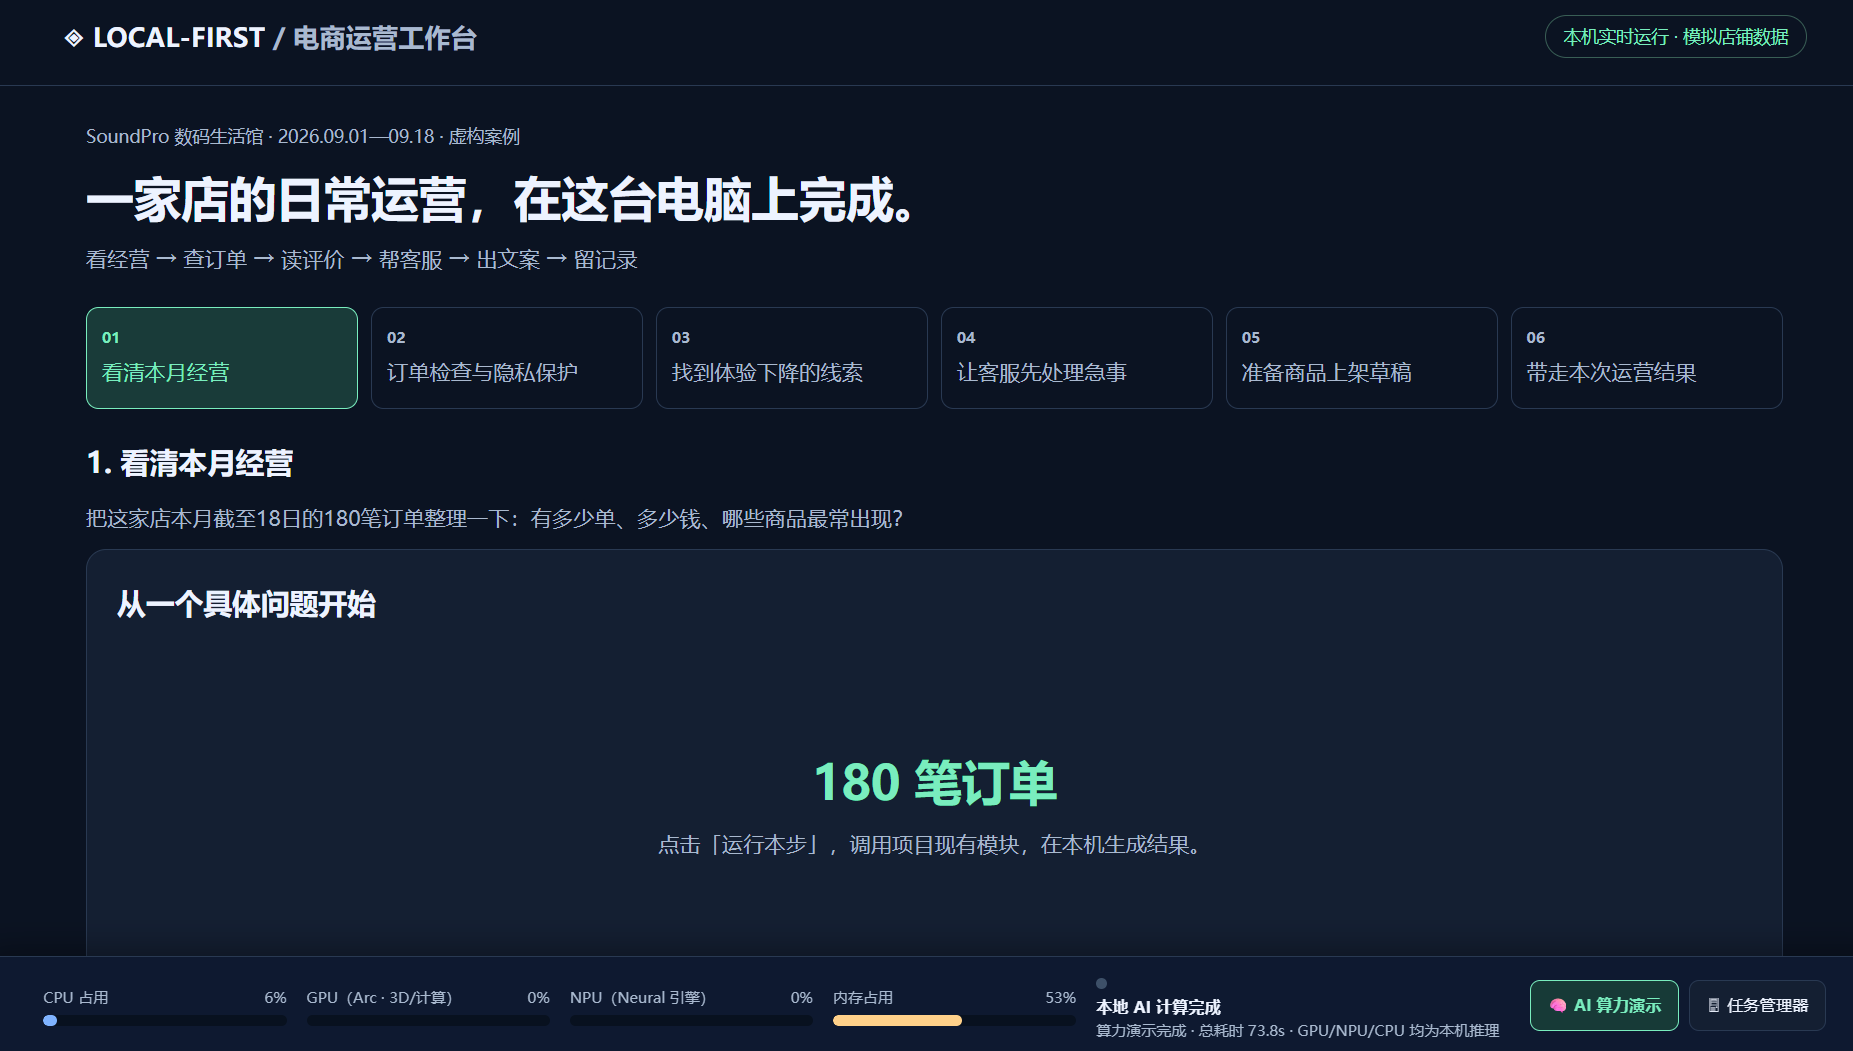
为了让本地 AI 不只是停留在架构图里,我们进一步做了个Demo。模拟店铺为 SoundPro 数码生活馆,整个工作台围绕真实电商运营流程设计。
DEMO:https://live.csdn.net/v/546490
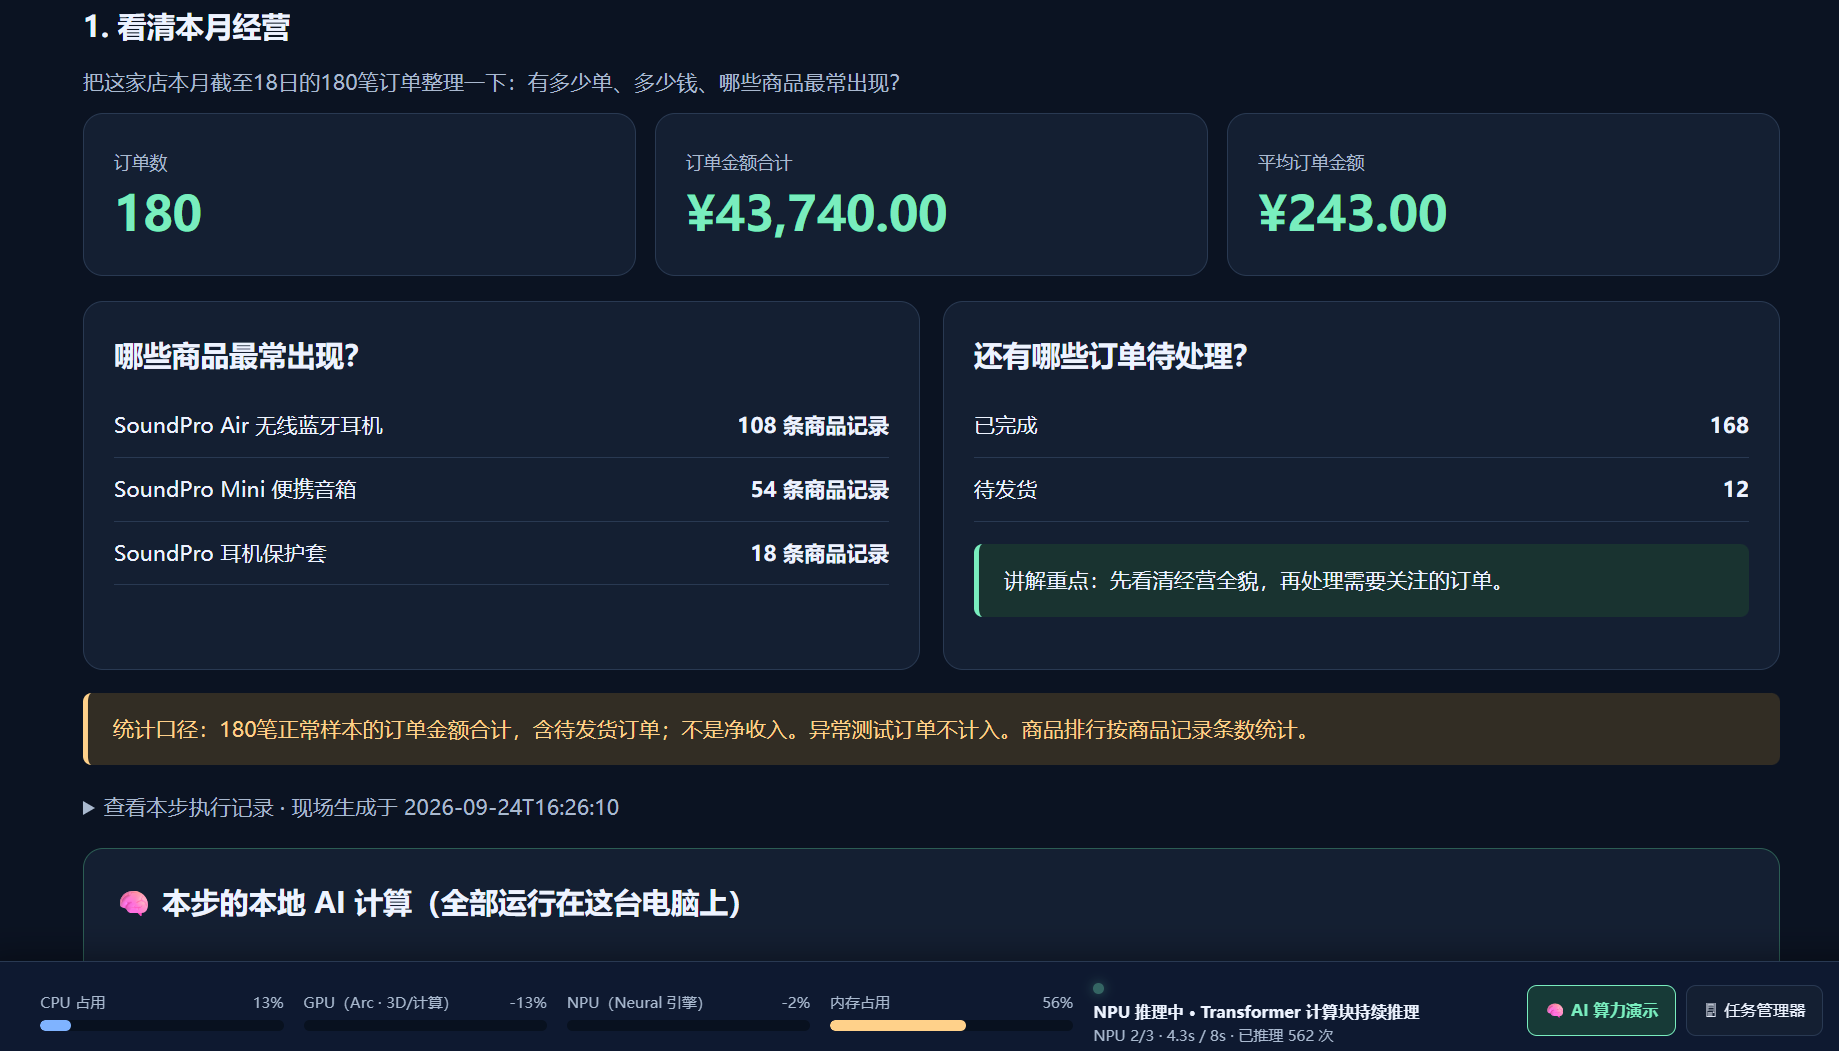
1. 看清本月经营
输入 180 笔订单后,系统可以在本地完成订单解析、统计和异常识别。
运营人员可以直接看到:
- 本月订单总金额
- 热销商品
- 待处理订单
- 异常订单
- 数据处理状态
最关键的是,页面直接标识当前任务由本地 AI 完成。
2. 看见 AI 到底跑在哪里
Demo 还增加了本地算力实时监控。
执行任务时,可以看到:
- GPU 上的 BERT 推理负载;
- NPU 上的 OCR 任务;
- CPU 上的规则计算;
- 对应的资源占用和执行时间。
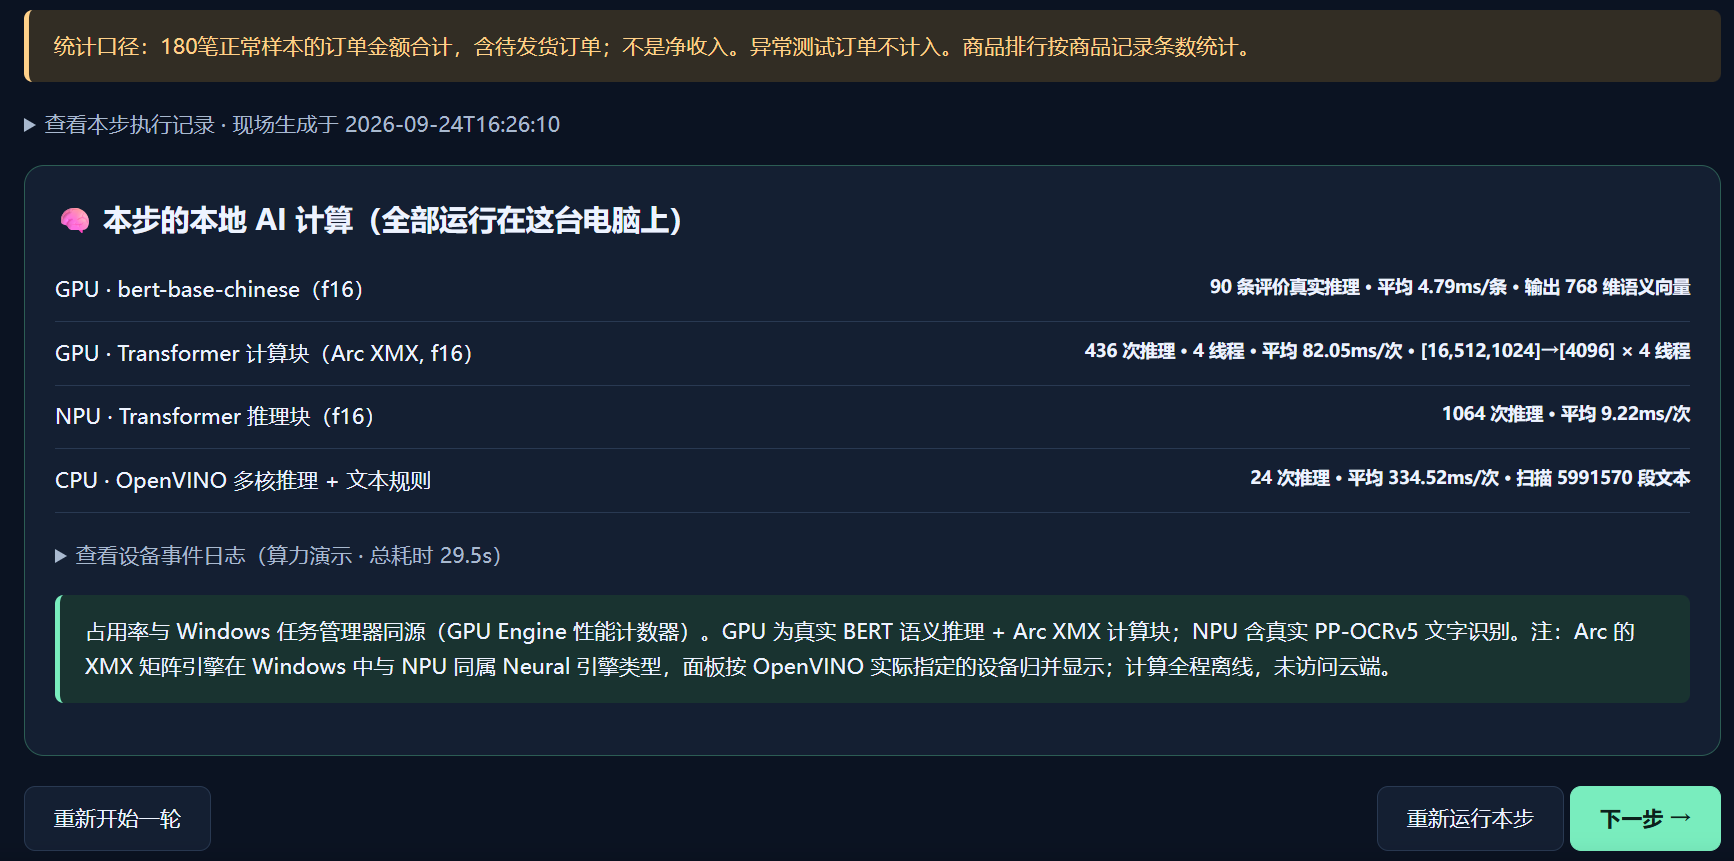
也就是说,Demo 不只是告诉你“AI 在本地运行”,而是把本地 AI 的运行过程直接展示出来。
四、关键不是“全部本地”,而是“数据分级 + 智能路由”
这里需要特别澄清一个概念:
Local-first ≠ 所有任务都不能上云。
模型在 PC 上运行,只能说明计算发生在端侧。
如果处理后的敏感文本又被完整返回到云端模型上下文,那么数据边界依然可能被突破。
因此,本项目没有简单采用“全部本地”的策略,而是加入了 PrivacyGuard。
四级数据分级
| 数据级别 | 典型数据 | 处理方式 |
|---|---|---|
| PUBLIC | 商品名称、价格、评分 | 按需上云 |
| INTERNAL | order_id、库存等 | 默认本地处理 |
| SENSITIVE | 评价内容、邮箱等 | 脱敏后才允许上云 |
| RESTRICTED | 姓名、电话、地址、支付信息 | 永不离开本机 |
手机号、邮箱、身份证、银行卡、地址等 PII 会被自动识别并替换为 、、 等占位符。
同时,订单解析、评价分析、客服建议等高频任务可以被标记为 force_local,即使输入中包含敏感信息,也优先在本地完成。
SkillRouter 决定“在哪里跑”
路由逻辑可以概括成:
Intent → 数据分级 → Local Skill? → Local Engine? → 云端白名单? → BLOCKED
例如:
- ****yze_review → BERT → GPU
- ocr_image → PP-OCRv5 → NPU
- parse_order → 含 PII → 强制本地
- 涉及 RESTRICTED 数据的外部查询 → 直接拦截
因此,本地优先并不是简单地“关掉云端”,而是:
让数据和任务找到最合适的执行位置。
五、三个真实场景:从订单到商品上架,一条链跑起来
场景 1:订单解析——敏感数据留在本机
一笔订单进入系统后,首先经过 PII 检测。
例如:
131XXXXXXXX
会被替换成:
<PHONE>
随后,OrderProcessor 在 CPU 上通过规则引擎提取:
- 订单号
- 商品
- 金额
- 状态
如果发现 ¥999,999 这样的大额订单,还可以自动标记:
“大额订单,建议人工复核”

整个过程不需要大模型,纯规则计算延迟 <1ms。
这也是整个架构非常重要的一点:
不是所有 AI 任务都需要大模型。
简单、确定、重复的任务交给 CPU 上的规则引擎,反而更快、更省。
最小验证提示词
请解析这批订单文本,自动脱敏手机号和地址,输出“订单号 / 商品 / 金额 / 状态 / 异常标记”表格,并汇总总额与状态分布。
场景 2:差评分析——让 BERT 跑在 GPU 上
评价分析是电商运营中非常高频的任务。
本项目将 bert-base-chinese 导出为 OpenVINO™ IR,并使用 GPU 进行 FP16 推理。
实测结果:
- 单次 BERT 推理约 5ms
- GPU 相比 CPU 加速约 14.2×
- 10 条评价可以批量完成情感分析和关键词提取
最终输出好评率、主题分布和高频关键词
例如输入 10 条评价后,可以自动得到:
好评率 → 高频关键词 Top10 → 重点差评 → 待跟进问题
而不是让运营人员逐条阅读和打标签。
相关实测数据显示,BERT-GPU 单次推理约 5ms,GPU 相比 CPU 的测试结果达到 14.2× 加速。
最小验证提示词
请对这 10 条评价做情感分析和关键词提取,输出好评率、高频关键词 Top10 和需要重点跟进的差评。
场景 3:商品上架——把多个工具串成一条流水线
商品上架往往需要 OCR、语音转写、文档解析、文案生成等多个工具。
如果每一步都人工操作,流程很容易被切碎。
本项目通过 workflow 将它们串联起来:
商品资料 → NPU OCR → GPU 语音转写 → 文档解析 → 标题 / 描述 / 标签生成 → listing.json
其中,NPU OCR 使用 PP-OCRv5。
对一张 800×400 的中文订单 / 商品截图进行测试:
- 7 行文字全部正确识别;
- 订单号、商品、金额、地址、电话、状态等字段均正确;
- 编译缓存命中后约 300ms / 图;
- 标题生成器一次生成 3 个版本并进行排序;
- 自动生成 SEO 标签并写入 listing.json。
最小验证提示词
请识别这张商品资料截图中的全部文字,按原始阅读顺序输出,并基于识别结果生成 3 个商品标题版本和 SEO 标签。
六、为什么是 GPU → NPU → CPU?
Agentic PC的价值,并不是简单地“多了一块 NPU”。
真正重要的是:
不同任务,由不同算力承担。 | 任务 | 首选设备 | 实测结果 | | --- | --- | --- | | BERT 文本分析 | GPU | 约 5ms / call,14.2× vs CPU | | OCR 图片识别 | NPU | 缓存后约 300ms / 图 | | ASR / TTS | GPU | 本地执行 | | 订单解析 / 隐私脱敏 | CPU | 规则计算 <1ms | | 通用算子 | GPU / NPU | 相比 CPU 分别约 4.30× / 3.05× |
系统通过 DeviceSelector 自动检测可用设备,并按照:
GPU → NPU → CPU
进行 fallback。
例如 GPU 被其他前台应用占用时,可以继续使用 NPU;如果 NPU 不可用,再回退到 CPU。
业务代码不需要感知具体设备。
这带来的价值非常直接:
让 GPU、NPU 和 CPU 各做自己擅长的事情。
七、最有意思的部分:整个项目是 TRAE “聊”出来的
如果只是把一个已经写好的项目跑起来,这个 Demo 的意义其实有限。
真正值得复现的是:
这个项目从架构设计到代码、测试和 Demo 迭代,都是由 TRAE 智能体根据自然语言提示词完成的。
整个过程没有要求开发者一开始就写完整代码,而是采用:
提出目标 → 让智能体实现 → 测试 → 发现问题 → 用自然语言修正 → 再验证
的方式逐步完成。
Prompt 1:先定义整个项目
可以直接告诉 TRAE:
帮我构建一个 local-first 的电商运营智能体。通过 local Agentic PC skills 在本地持续处理订单等隐私信息,然后对客户评价、商品资料以及音视频内容进行分析、总结、内容生成与实时辅助;私有、高频任务充分利用 CPU/GPU/NPU 等本地算力,仅在需要外部信息时连接云端,降低云端 token 消耗并保护经营等隐私数据。
TRAE 随后完成环境盘点、架构设计和核心代码生成。
Prompt 2:用自然语言调整算力策略
第一版完成后,可以继续告诉 TRAE:
我没有说清楚。下一步执行落地计划,将真实模型应首先考虑加载到 GPU,当 GPU 算力已被占用时,再考虑加载到 NPU。然后实际调用 local skills 以及构建视频批量流水线。
这一轮之后,设备调度逻辑被进一步明确为:
GPU → NPU → CPU
并完成 BERT-GPU 和 NPU OCR 的实际验证。
Prompt 3~6:让智能体自己完成质量闭环
接下来继续用自然语言要求:
请为刚才构建的电商智能体生成一份完整的落地总结报告。
请为刚才生成的落地报告补充一份详细的测试验证方案。
按测试方案执行验证。
请生成一份包含测试结果的完整落地总结报告。
最终,智能体完成了 6 层测试体系、27 个测试用例,并对失败用例进行修复。
结果:
27 / 27 PASS
八、甚至可以让 TRAE 把“本地 AI”展示出来
在展台 Demo 的迭代过程中,还遇到了一个很现实的问题:
功能确实在本地跑,但观众看不见。
于是继续给 TRAE 一个非常直接的需求:
我发现问题:看板展示的功能比较清晰,但点击“运行本步”时,看不到本机上的 AI 推理过程,需要把本地运行的过程展示出来——打开任务管理器,能看到运行时 AI 负载跑在本机的 CPU、GPU 或 NPU 上。
随后,TRAE 增加了本地算力实时面板。
点击“运行本步”后,后台真实执行 BERT-GPU、NPU OCR 和 CPU 规则推理,同时同步展示本机资源占用。
这样,“AI 在本地运行”从一句介绍,变成了现场可以直接观察的证据。
九、10 分钟,把这个 Demo 跑起来
如果你也有一台支持 GPU + NPU 的英特尔 AI PC,可以从最小实验开始。
环境
- Windows 10 / 11 64 位
- 英特尔 AI PC(Core Ultra,具备可用 GPU + NPU)
- Python 3.12.10
- OpenVINO™ 2026.1.0
- bert-base-chinese
- PP-OCRv5
- TRAE CN Local Skills
项目中使用了:
local-asr / local-ocr-npu / local-mineru / local-tts / local-txt2img
详细环境和依赖信息见原项目说明。
Step 1:确认 Agentic PC的异构算力
python -c "import openvino; print(openvino.Core().available_devices)"
预期看到:
['CPU', 'GPU', 'NPU']
Step 2:跑通 5 个核心场景
python -m src.main
预期:
- 订单解析
- 评价情感分析
- 商品标题生成
- 客服回复建议
- 批量评价汇总
- 均可完成本地执行。
Step 3:验证 GPU / NPU 加速
python test***enchmark_ov.py
预期结果:
- GPU ≈ 4.30× vs CPU
- NPU ≈ 3.05× vs CPU
Step 4:验证 NPU OCR
使用项目自带的订单截图运行 OCR,检查订单号、商品、金额、地址、电话、状态等字段。
Step 5:启动 API
uvicorn src.api.server:app --port 8000
随后即可通过 /health 和 /run 验证设备状态和任务执行结果。
Step 6:一键跑完整测试
python tests/run_all_tests.py
预期:
- 27/27 PASS
完整的验证流程和通过标准可直接按照项目中的测试清单执行。
十、几个必须说明的技术边界
为了让这个案例更接近真实生产环境,有几个边界也需要说清楚。
1. 第一次运行为什么比较慢?
BERT 和 NPU OCR 第一次运行会包含模型编译过程,因此明显慢于后续调用。
编译完成后会使用缓存,后续推理速度会明显提升。
生产部署时,可以考虑在服务启动阶段完成模型预热。
2. 本地推理 ≠ 自动拥有完整隐私保护
真正决定数据边界的是:
PrivacyGuard + 数据分级 + 路由策略 + 云端上下文控制。
因此,上线前仍然需要结合企业自身的数据合规要求进行复核。
3. 规则引擎和大模型各有适用范围
目前订单解析、客服意图和部分商品文案主要由规则和模板驱动。
这样做的优势是速度快、成本低,但能力边界也更明确。
如果需要更强的生成能力,可以进一步增加云端 LLM 作为低置信度场景的补充路径,但敏感数据仍应遵循既定的数据边界。
这些边界也是 LOCAL-FIRST 架构真正落地时需要重点关注的部分。
十一、如果需要更强的云端能力,也不必“非黑即白”
本地优先并不意味着拒绝云端。
更合理的方式是:
敏感、高频、低延迟任务 → 本地
公开内容、复杂总结、多轮理解等任务 → 云端
例如,在 TRAE 中进一步配置火山引擎 Plan,可以把云端模型作为复杂任务的补充能力。
这样形成的其实是一种更加实用的:
端云协同智能体架构。
数据在哪里处理、模型在哪里运行,并不是固定答案,而是根据数据敏感程度、任务类型和算力条件动态决定。
需要强调的是,即使接入云端能力,订单、客户和支付等 RESTRICTED 数据仍应留在本机。
十二、从“会聊天”到“会干活”,Agentic PC正在成为智能体的执行端
这个 Demo 最值得关注的,并不是某一个 OCR、BERT 或 API。
真正有意义的是整个链路:
自然语言需求 → TRAE 智能体 → Skills → PrivacyGuard → 智能路由 → CPU / GPU / NPU → 业务结果
对于电商运营来说,它意味着:
- 订单可以在本地解析;
- 差评可以在本地批量分析;
- 商品资料可以自动 OCR;
- 文档、音视频可以进入统一工作流;
- 不同 AI 工具可以被智能体串联;
- 敏感数据可以按照规则留在本机;
- 高并发、重复性任务可以减少对云端 API 的依赖。
本项目的实测结果也验证了这一思路:
BERT-GPU 单次推理约 5ms、GPU 相比 CPU 达到 14.2× 加速;NPU OCR 缓存后约 300ms / 图;27 个测试用例全部通过。
更重要的是,这套系统并不是一个只能“看 Demo”的概念验证。
它已经具备 API、Skills、数据分级、设备调度和测试体系,可以继续向更多业务场景扩展。
写在最后:从一个 Prompt 开始
如果你也有一台支持 CPU / GPU / NPU 异构计算的英特尔 AI PC,不妨从最简单的一句话开始:
“帮我构建一个 local-first 的电商运营智能体,让敏感数据优先留在本机,并充分利用 CPU / GPU / NPU 完成本地任务。”
然后,让 TRAE 帮你完成后面的工作。
从订单解析开始,再加入 OCR、评价分析、ASR、TTS、文档处理和内容生成。
你会发现,Agentic PC的意义并不只是“本地跑一个模型”。
真正的变化,是让 AI 从一个需要不断对话的工具,变成一个能够理解任务、调用 Skills、调度异构算力,并在真实业务流程中持续执行的智能体。
下一步:打开 TRAE CN,把上面的 Prompt 1 交给智能体,在你自己的 Agentic PC 上复现这个项目。
从一次订单解析开始,看看你的 Agentic PC能把多少电商运营工作真正“接过来”。